Что такое CTE в SQL и зачем он нужен
CTE (Common Table Expression, или общее табличное выражение) — результат запроса с собственным названием, доступный в пределах одной инструкции SQL. Вы описываете выборку, а затем обращаетесь к ней примерно так же, как к таблице.
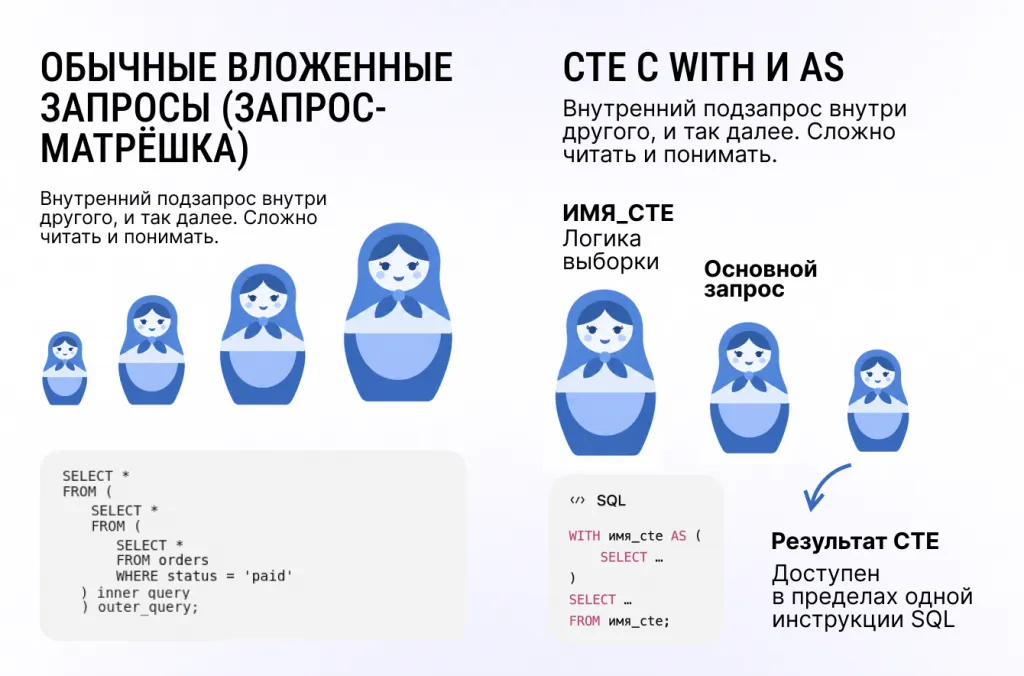
Зачем добавлять ещё одну конструкцию? К примеру, вам нужно отобрать записи, посчитать показатели и сравнить их. Если поместить вычисления во вложенные запросы в SQL, придётся разбираться, где заканчивается одна выборка и начинается следующая. Запрос буквально превращается в матрёшку.
CTE позволяет разобрать эту матрёшку: вынести этапы наверх и подписать каждый — таким образом получается понятная последовательность.
Начнём с небольшого запроса (здесь и далее — условные примеры, в своей базе замените их на реальные):
WITH active_users AS (
SELECT id, name
FROM users
WHERE status = 'active'
)
SELECT * FROM active_users;
Внутри скобок отбираем из <users> активных пользователей со столбцами <id> и <name>. Выборку называем <active_users>. Последний SELECT выводит её данные.
Читается сверху вниз как обычный текст. Именно за это CTE и любят: он повышает читаемость и упрощает поддержку кода, когда логика растёт.
От понятного примера — к своему запросу
В примере выше всё на месте: таблица известна, условие задано, столбцы уже выбраны. А в рабочей задаче сначала нужно решить, откуда вообще брать информацию и как её связать.
На курсе «SQL с нуля для анализа данных» вы пройдёте путь от первых выборок до соединения таблиц, группировки и оконных функций. Запросы будете писать прямо в тренажёрах, а теорию разбирать на примерах из реальных рабочих ситуаций. Заниматься можно в своём темпе, а материалы и обновления останутся у вас навсегда.
В итоге жизнь станет легче: нужные срезы сможете собирать самостоятельно, не растягивая одну задачу на несколько кругов согласований. Независимость в действиях — основа крепкого специалиста.
Как работает оператор WITH и базовый синтаксис WITH AS SQL
Логика всегда одна: сначала объявляем CTE, затем пишем основной запрос. В многоточия подставляем свой код:
WITH имя_cte AS (
SELECT ...
)
SELECT ...
FROM имя_cte;
Что входит в структуру запроса:
WITH — начало объявления. С этого слова стартует вся конструкция.
имя_cte — то, как мы обратимся к результату дальше.
AS ( ... ) — определение запроса (<query_definition>). Внутри скобок живёт логика выборки.
SELECT — основная часть, ради которой всё затевалось. Она обращается к <имя_cte>, будто это настоящая таблица.
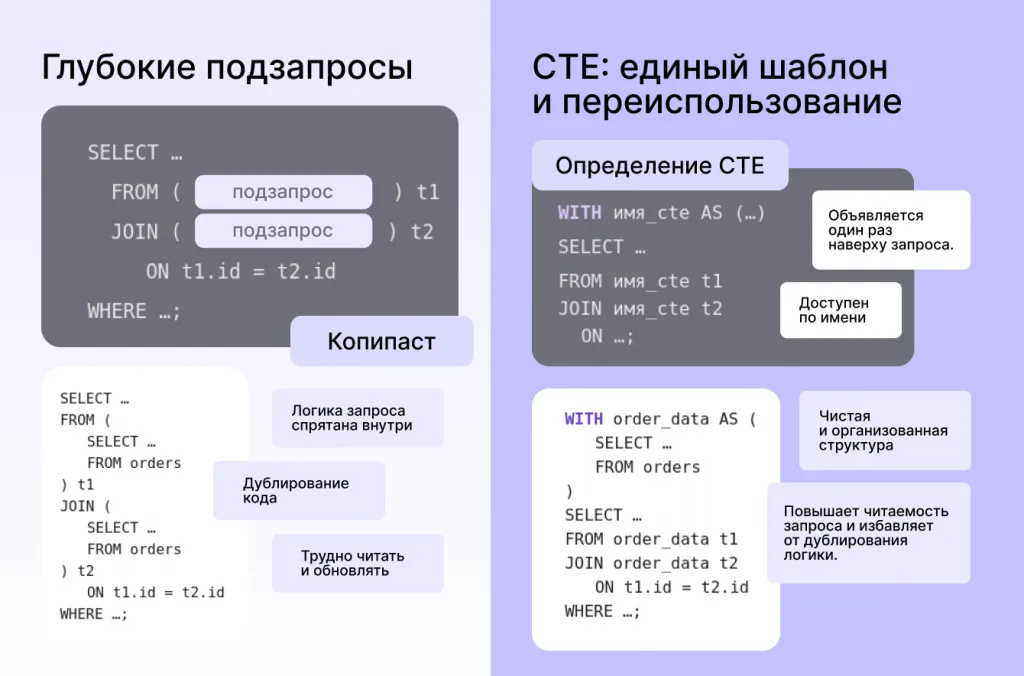
Чем это отличается от подзапроса: вложенный запрос — выборка, встроенная внутрь другой, например в FROM, JOIN или WHERE. Этот запрос спрятан внутри и часто дублируется, если нужен в нескольких местах.
CTE же вынесен наверх, объявлен один раз и доступен по имени в рамках текущего запроса. При этом область видимости CTE ограничена только одной инструкцией SQL: он не сохраняется в сессии и не виден в последующих запросах. Проще говоря, появляется разница между «спрятать в скобках» и «дать понятное название и переиспользовать».
Примеры простого CTE от фильтрации до вычислений
Сценарий 1: предварительная агрегация
Допустим, нам нужно найти клиентов с общей суммой покупок выше средней. Сначала посчитаем сумму заказов каждого клиента. Затем вынесем расчёт в CTE, а сравнение оставим снаружи. Через вложенные подзапросы эта логика заняла бы несколько уровней.
WITH total_sales AS (
SELECT customer_id, SUM(amount) AS total_amount
FROM orders
GROUP BY customer_id
)
SELECT customer_id, total_amount
FROM total_sales
WHERE total_amount > (
SELECT AVG(total_amount)
FROM total_sales
);
Обратите внимание, что набор <total_sales> мы используем дважды, но описали лишь один раз. Это и есть снижение дублирования логики.
Сценарий 2: вычисляемые столбцы и фильтрация
Добавим вычисляемый столбец <tax> и отберём заказы, в которых его значение больше 100:
WITH order_stats AS (
SELECT
order_id,
amount,
amount * 0.2 AS tax
FROM orders
)
SELECT order_id, amount, tax
FROM order_stats
WHERE tax > 100;
Сначала вычисляем налог, затем фильтруем. Сформировали результирующий набор → отобрали нужные строки.
Чем CTE отличается от подзапросов
Оба способа полезны. Вопрос в том, какую запись вам проще читать, проверять и менять в задаче.
|
Критерий |
CTE |
Подзапрос |
|---|---|---|
|
Читаемость |
Именованные этапы удобно читать сверху вниз |
Глубокую вложенность приходится разбирать изнутри наружу |
|
Переиспользование |
Одно определение доступно несколько раз внутри инструкции |
В другом месте текст выборки часто приходится повторять |
|
Отладка |
Можно вывести результат необходимого этапа |
Вложенную часть сначала нужно отделить от окружающего кода |
|
Простые случаи |
Для одной короткой выборки может быть избыточен |
Даёт быстрый ответ вложенных подзапросов без отдельного объявления CTE |
Вывод: если нужен один короткий фильтр — обычный подзапрос отлично справится и не будет перегружать код. А вот когда логика многоступенчатая или промежуточный результат используется повторно, сложные SQL запросы почти всегда чище переписать через WITH.
Рекурсивный CTE и рекурсивные запросы SQL
Иногда данные ссылаются сами на себя. Бытовой пример: руководитель → его подчинённые → их подчинённые. Или дерево категорий интернет-магазина. Для таких иерархий и придуманы рекурсивные запросы.
У них две основные части:
-
Якорная — стартовая точка, она же база (например самый верхний руководитель).
-
Рекурсивная — расширяет результат: находит подчинённых, дочерние категории или следующее число в последовательности.
Обе части соединяются через <UNION ALL>. Пример генерации последовательности из документации MySQL:
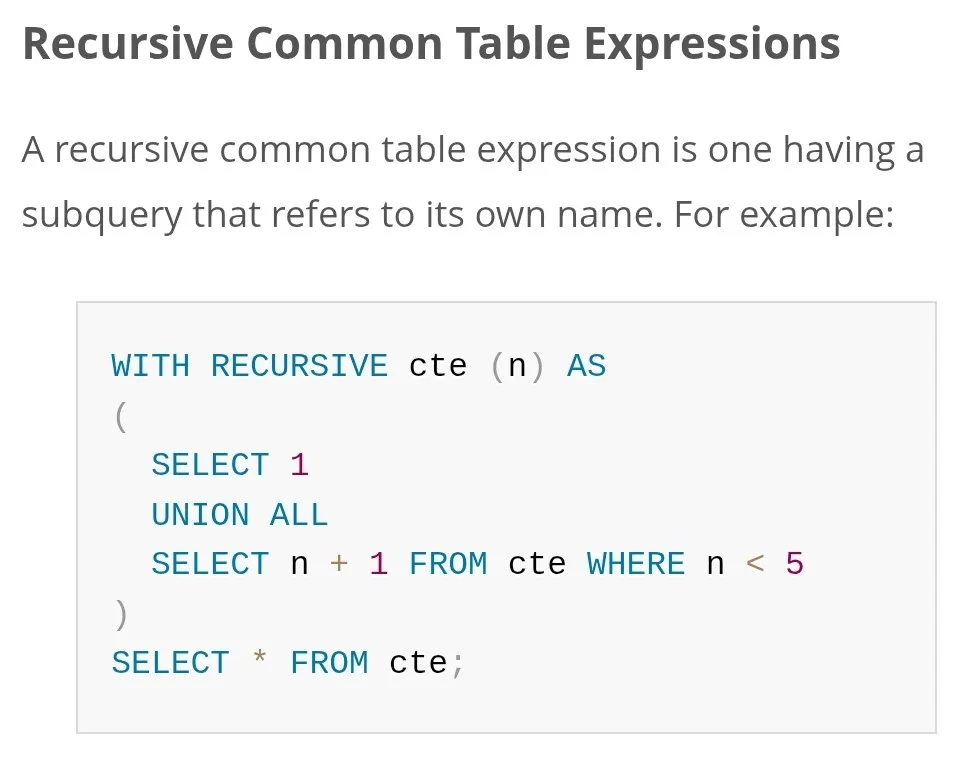
<cte> — имя выражения, <(n)> — имя столбца. SELECT 1 создаёт начальную строку. Затем рекурсивная часть проверяет n < 5 и возвращает n + 1.
Получатся числа от 1 до 5.
Почему пятёрка тоже попадёт в результат? Потому что проверяется предыдущее значение: четвёрка подходит под n < 5, поэтому запрос возвращает пятёрку. На следующем шаге она проверку уже не пройдёт.
Без WHERE n < 5 в этом примере не останется условия завершения. MySQL прервёт выполнение после достижения лимита рекурсии и вернёт ошибку.
Теперь пример иерархии сотрудников для SQL Server:
WITH employee_hierarchy AS (
SELECT id, full_name, manager_id
FROM employees
WHERE id = 4
UNION ALL
SELECT e.id, e.full_name, e.manager_id
FROM employees e
JOIN employee_hierarchy h ON e.manager_id = h.id
)
SELECT * FROM employee_hierarchy;
<id> обозначает сотрудника, <manager_id> — его руководителя. Начинаем с <id = 4>: через JOIN находим прямых подчинённых, затем подчинённых этих людей. Результат включает сотрудника №4 и всю найденную ветку ниже него.
Визуально это выглядит примерно так:
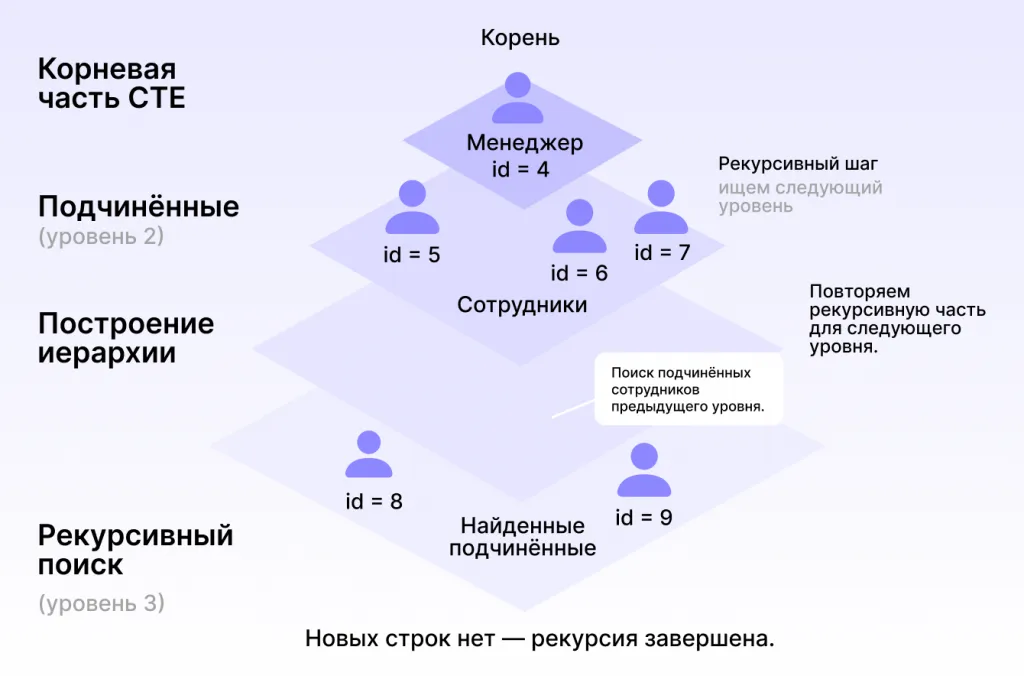
Важно: отдельного WHERE для остановки здесь нет. В конечной иерархии запрос завершится, когда JOIN не найдёт подчинённых. Но при цикле в связях он может снова прийти к пройденному сотруднику. Поэтому проверять нужно и код, и данные.
Для защиты от слишком глубокой рекурсии у СУБД есть разные средства:
-
В SQL Server по умолчанию разрешено 100 уровней рекурсии. Лимит можно задать через OPTION (MAXRECURSION N) в конце основного запроса. Значение 0 снимает ограничение, поэтому не используйте его просто ради исчезновения ошибки.
-
В MySQL переменная <cte_max_recursion_depth> по умолчанию равна 1000. Настройка конкретного сервера или сессии может отличаться.
-
В PostgreSQL нет аналогичного автоматического лимита числа уровней. Для иерархий можно отслеживать уже посещённые узлы, а в версиях, которые её поддерживают — использовать конструкцию CYCLE, время выполнения ограничить через <statement_timeout>.
Запомнить: перед запуском проверять не только запрос, но и структуру связей в таблице.
Примеры для PostgreSQL, MySQL, SQL Server и Oracle
Идея CTE одинакова везде, но диалекты имеют нюансы. Разберём каждый.
PostgreSQL
Поддерживает и WITH, и WITH RECURSIVE. Для рекурсивного выражения нужно ключевое слово RECURSIVE. Пример WITH SQL POSTGRESQL:
WITH RECURSIVE nums AS (
SELECT 1 AS n
UNION ALL
SELECT n + 1 FROM nums WHERE n < 5
)
SELECT * FROM nums;
Это та же последовательность от 1 до 5. Имя столбца здесь задаёт <AS n> в якорной части.
В PostgreSQL CTE может вычисляться отдельно или встраиваться в общий план запроса — это зависит от версии, структуры запроса и числа обращений к CTE. Поэтому WITH сам по себе не ускоряет код. В сложных случаях поведением управляют через MATERIALIZED и NOT MATERIALIZED, но на начальном этапе достаточно помнить, что CTE нужен ради понятной структуры, а скорость лучше проверить отдельно.
MySQL
В MySQL CTE появились в версии 8.0. Раньше конструкции WITH не было: аналогичную логику приходилось записывать через подзапросы или другие доступные средства.
Синтаксис похож на PostgreSQL: WITH для обычного CTE, WITH RECURSIVE — для рекурсивного:
WITH RECURSIVE nums (n) AS (
SELECT 1
UNION ALL
SELECT n + 1
FROM nums
WHERE n < 5
)
SELECT n
FROM nums;
Microsoft SQL Server (MS SQL)
Здесь тоже ключевое слово RECURSIVE не пишется. Ссылка CTE на собственное имя и делает его рекурсивным — так устроен пример с сотрудниками выше.
Если перед WITH в том же пакете есть другая инструкция, завершите её точкой с запятой <;WITH>. Точка с запятой закрывает предыдущую инструкцию, для самостоятельного запроса <;WITH> не обязателен:
WITH nums AS (
SELECT 1 AS n
UNION ALL
SELECT n + 1
FROM nums
WHERE n < 5
)
SELECT n
FROM nums
OPTION (MAXRECURSION 100);
Oracle
Поддерживает WITH, в том числе рекурсивные выражения. После имени для них обязательно перечисляют столбцы: например <WITH nums (n) AS (...)>. Ключевое слово RECURSIVE тоже не нужно: якорную и рекурсивную части соединяют через <UNION ALL>. Исторически в Oracle иерархии строили через <CONNECT BY>, но современные версии полноценно понимают и рекурсивный CTE.
Для запроса без исходной таблицы используется DUAL:
WITH nums (n) AS (
SELECT 1
FROM dual
UNION ALL
SELECT n + 1
FROM nums
WHERE n < 5
)
SELECT n
FROM nums;
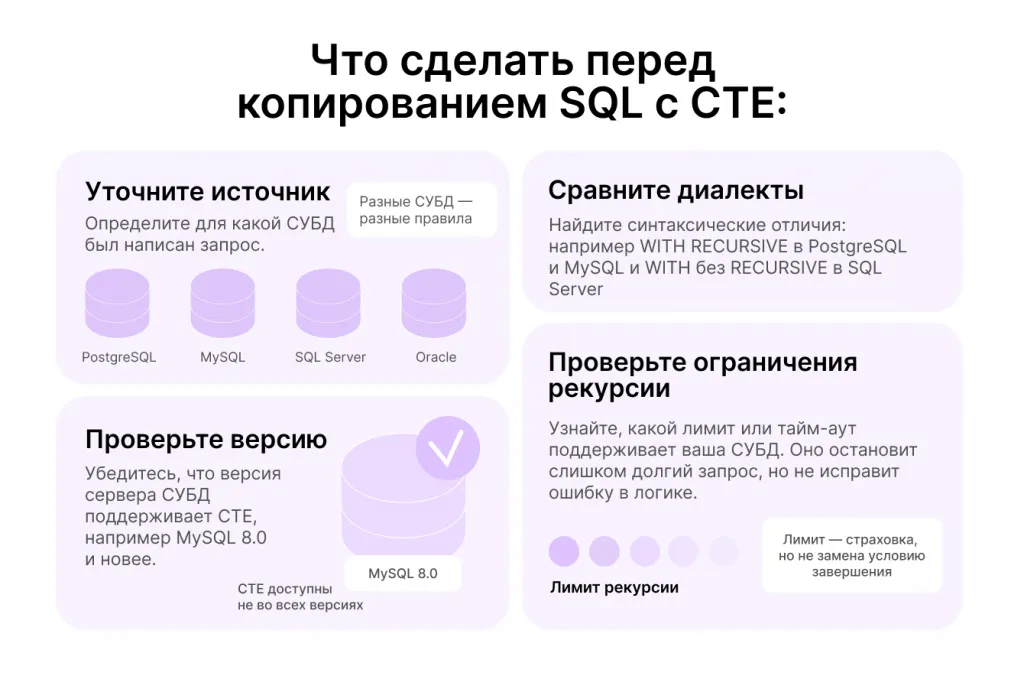
Главный практический совет: всегда проверяйте версию СУБД и диалект перед тем, как копировать чужой запрос.
Несколько CTE в одном запросе: ошибки и ограничения
Если этапов больше одного, не спешите писать новое WITH перед каждым. Просто объявите CTE через запятую:
WITH
sales AS (
SELECT customer_id, SUM(amount) AS total
FROM orders
GROUP BY customer_id
),
big_clients AS (
SELECT customer_id FROM sales WHERE total > 1000
)
SELECT * FROM big_clients;
Заметьте: второй CTE <big_clients> спокойно ссылается на первый <sales>. Это работает как цепочка — каждый следующий может опираться на предыдущий.
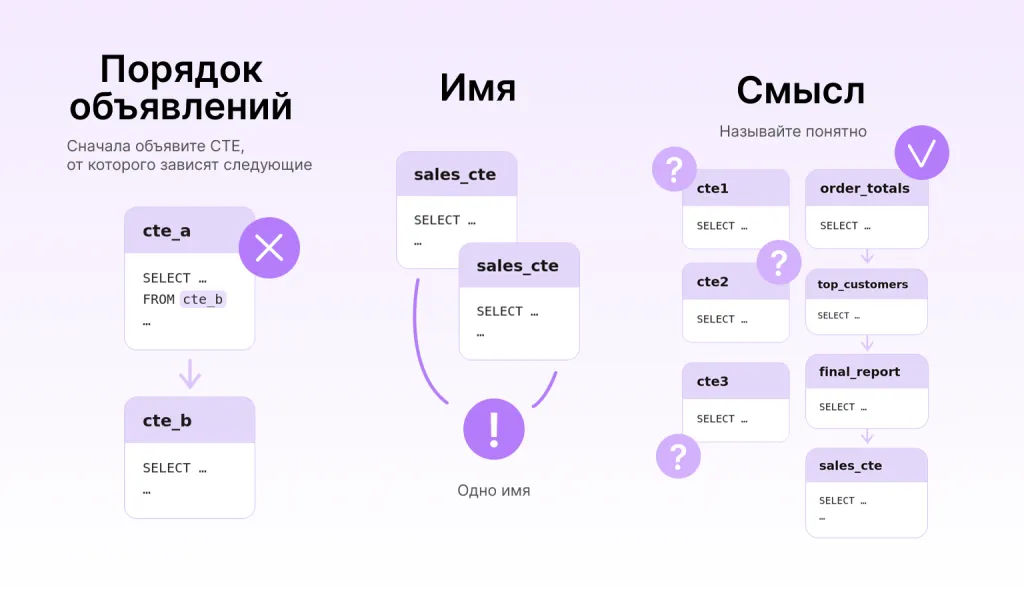
Что чаще всего мешает такой конструкции:
-
Неверный порядок объявлений. Для запроса, который должен работать в разных СУБД, располагайте CTE в порядке зависимостей: сначала выражение, которое готовит данные, затем то, которое к нему обращается.
-
Повторное имя. Два CTE с одинаковым именем — гарантированная ошибка. Имена должны быть уникальными.
-
Отсутствие понятной логики. Если CTE называется <cte1>, <cte2>, <cte3>, вы сами запутаетесь. Давайте осмысленные имена.
Что проверить перед выполнением запроса: уникальность имён, порядок объявлений, наличие условия остановки для рекурсии и поддержку CTE вашей версией СУБД.
Краткий вывод и практические советы
Выбирайте CTE для многоступенчатых расчётов и повторных обращений к выборке. Для короткого фильтра оставьте подзапрос, если его проще проверить.
Рекурсия подходит для иерархий, деревьев и последовательностей. Но в любом случае нужны понятное завершение и защита от циклов.
Мини-чек-лист чтения запроса с WITH:
Начните с малого: возьмите один свой запутанный запрос с вложенностью и перепишите его через WITH. Разница в читаемости станет очевидной сразу.
Теперь запрос легче читать и менять? Отлично!
Следующий вопрос — как использовать его результат: проверить данные, посчитать нужные метрики и показать их так, чтобы коллегам не понадобился отдельный созвон по каждой колонке.
На курсе «Инструменты аналитики данных + ИИ» вы освоите SQL, Excel, Power BI и Python вместе. Практиковаться будете на обработке таблиц, расчётах, создании интерактивных панелей (дашбордов), а ещё научитесь ускоряться с помощью нейросетей.
Такие навыки пригодятся как в текущей работе, так и при переходе к более сложным аналитическим ролям: вы сможете показывать не только цифры, но и выводы, на которых принимают решения. А это обычно всегда рост в должности и зарплате.


